
Set 接口
1.Set
1.1概述
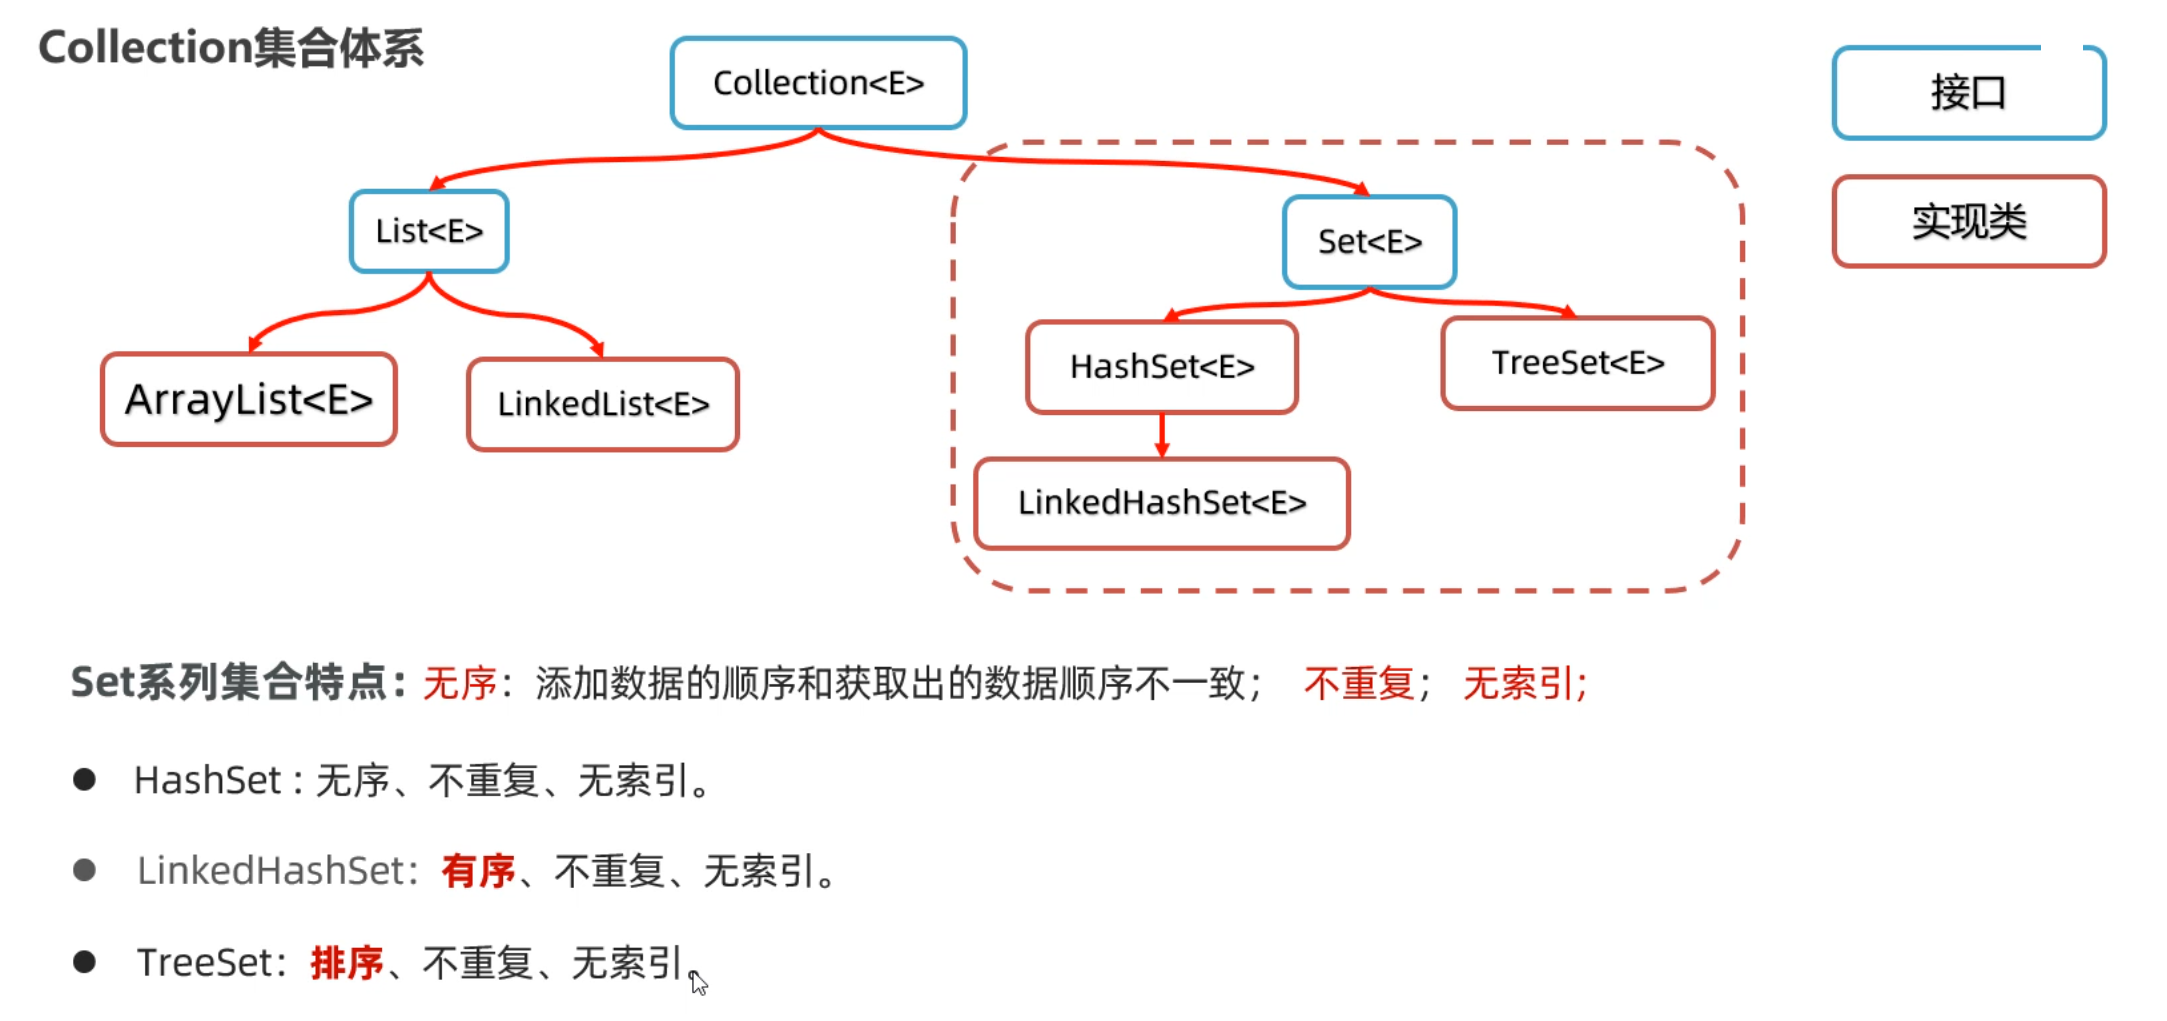
1)概述:是一个接口
2)实现类:HashSet LinkedHashSet TreeSet
3)Set 系列集合的特点:无序、不重复、无索引
4)今天介绍的这三个实现类都是线程不安全的
1.2示例:不同实现类的特点
package com.itheima.d1_collection_set;

import com.sun.source.tree.Tree;

import java.util.HashSet;
import java.util.LinkedHashSet;
import java.util.TreeSet;

/*
    目标:整体了解一下Set系列集合的特点

    Set集合的体系特点
        HashSet : 无序、不重复、无索引。
        LinkedHashSet:有序、不重复、无索引。
        TreeSet:排序、不重复、无索引。

    需求 : 演示Set集合的每一个实现类的特点
 */
public class SetTest1 {
    public static void main(String[] args) {
        System.out.println("HashSet: ");
        HashSet<Object> hs1 = new HashSet<>();
        // 添加元素
        hs1.add("bca");
        hs1.add("bca");
        hs1.add("cab");
        hs1.add("abc");
        // 打印集合对象
        System.out.println(hs1);

        System.out.println("LinkedHashSet: ");
        HashSet<Object> hs2 = new LinkedHashSet<>();
        // 添加元素
        hs2.add("bca");
        hs2.add("bca");
        hs2.add("cab");
        hs2.add("abc");
        // 打印集合对象
        System.out.println(hs2);

        System.out.println("TreeSet: ");
        TreeSet<Object> hs3 = new TreeSet<>();
        // 添加元素
        hs3.add("bca");
        hs3.add("bca");
        hs3.add("cab");
        hs3.add("abc");
        // 打印集合对象
        System.out.println(hs3);
    }
}
运行结果
HashSet:
[bca, abc, cab]
LinkedHashSet:
[bca, cab, abc]
TreeSet:
[abc, bca, cab]
1.3思考
1)共同特点
- 全部不能存储重复元素,重复添加的
"bca"只会保留一份。 - 没有索引,不能通过索引取值。
2)HashSet
- ✅去重;❌存取无序,元素顺序和添加顺序无关,依靠哈希值决定存放位置。
3)LinkedHashSet
- ✅去重;✅存取有序,元素顺序等于你调用
add()添加的先后顺序;底层是哈希表 + 双向链表维护顺序。
4)TreeSet
- ✅去重;✅自动排序,字符串按照字典(字母)顺序升序排列;
1.4关于哈希值
1)是什么
哈希值:是JDK 根据对象的地址、或者对象的内容,算出来的一个 int 类型整数。
每一个对象都有自己的哈希值
2)两个关键点
- 同一个对象,多次调用
hashCode() ,返回的哈希值一定相同 - 不同的对象,哈希值有可能相同 → 哈希冲突
2.HashSet
2.1 概述
HashSet集合底层是基于哈希表实现的,哈希表根据JDK版本的不同,也是有点区别的
- JDK8以前:哈希表 = 数组+链表
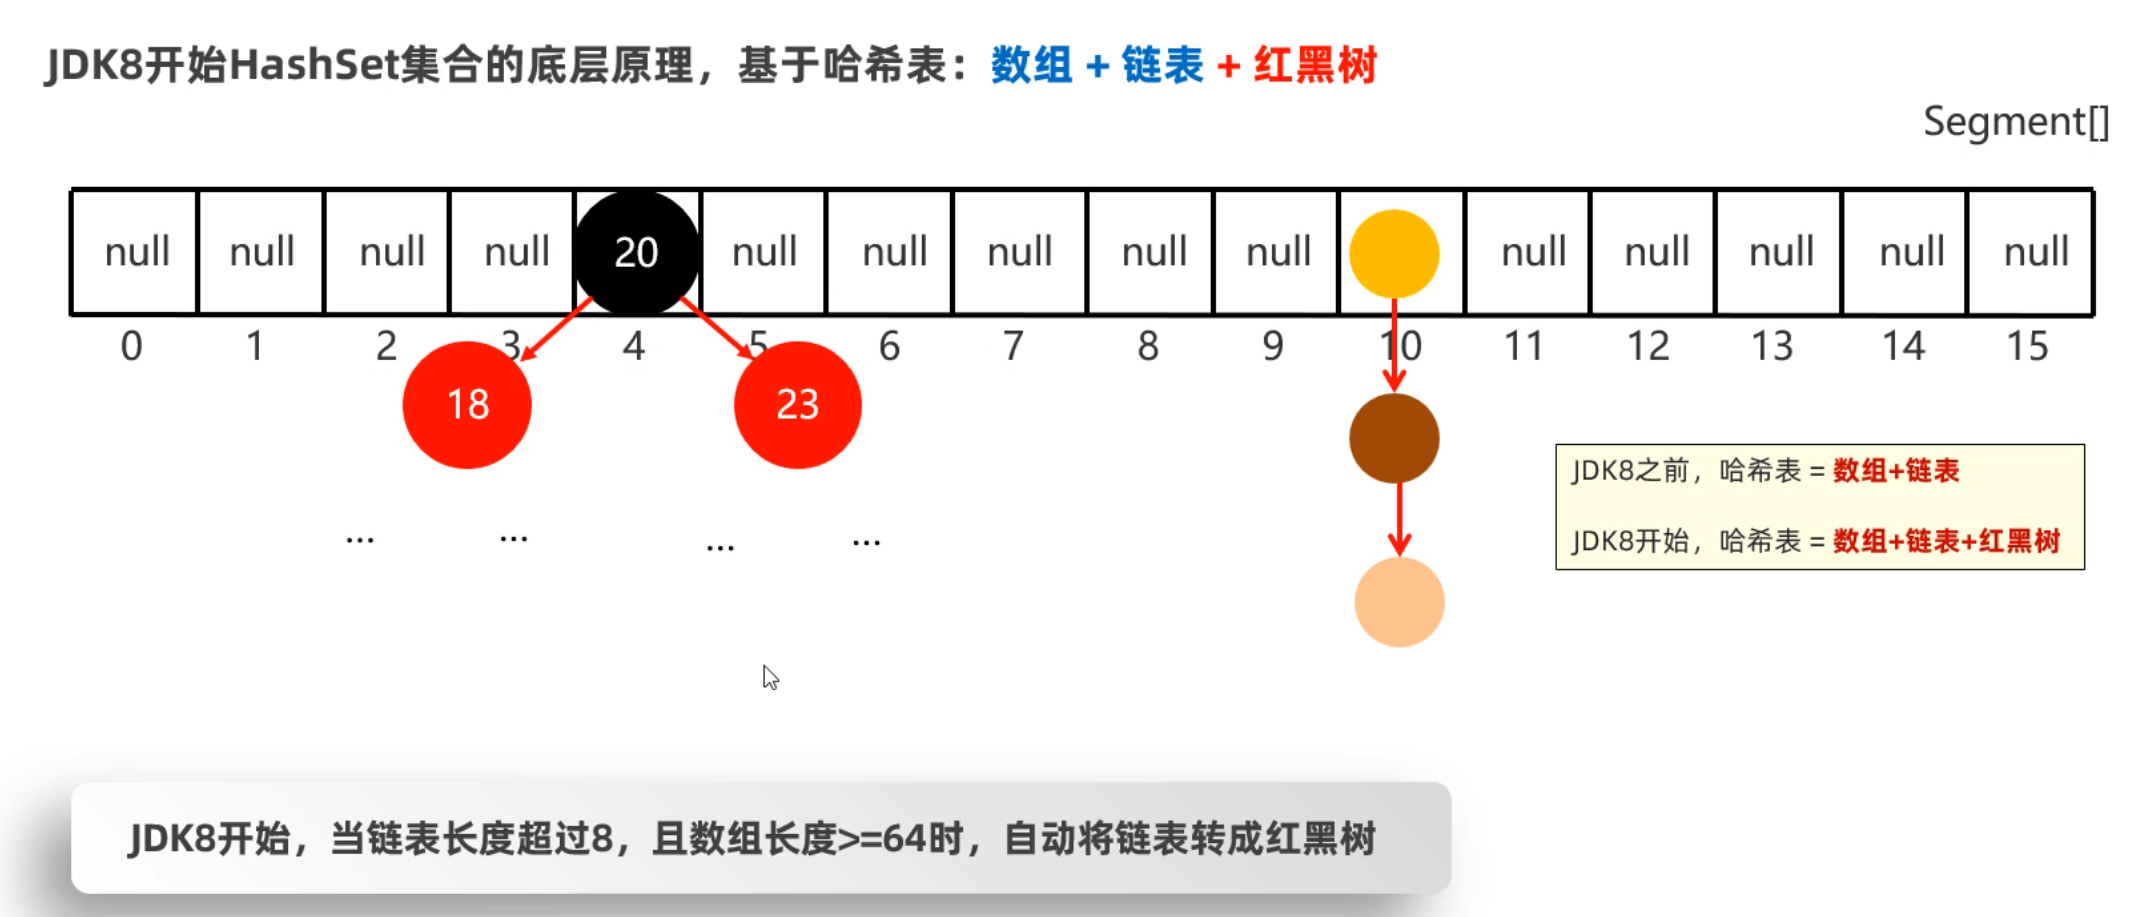
- JDK8以后:哈希表 = 数组+链表+红黑树
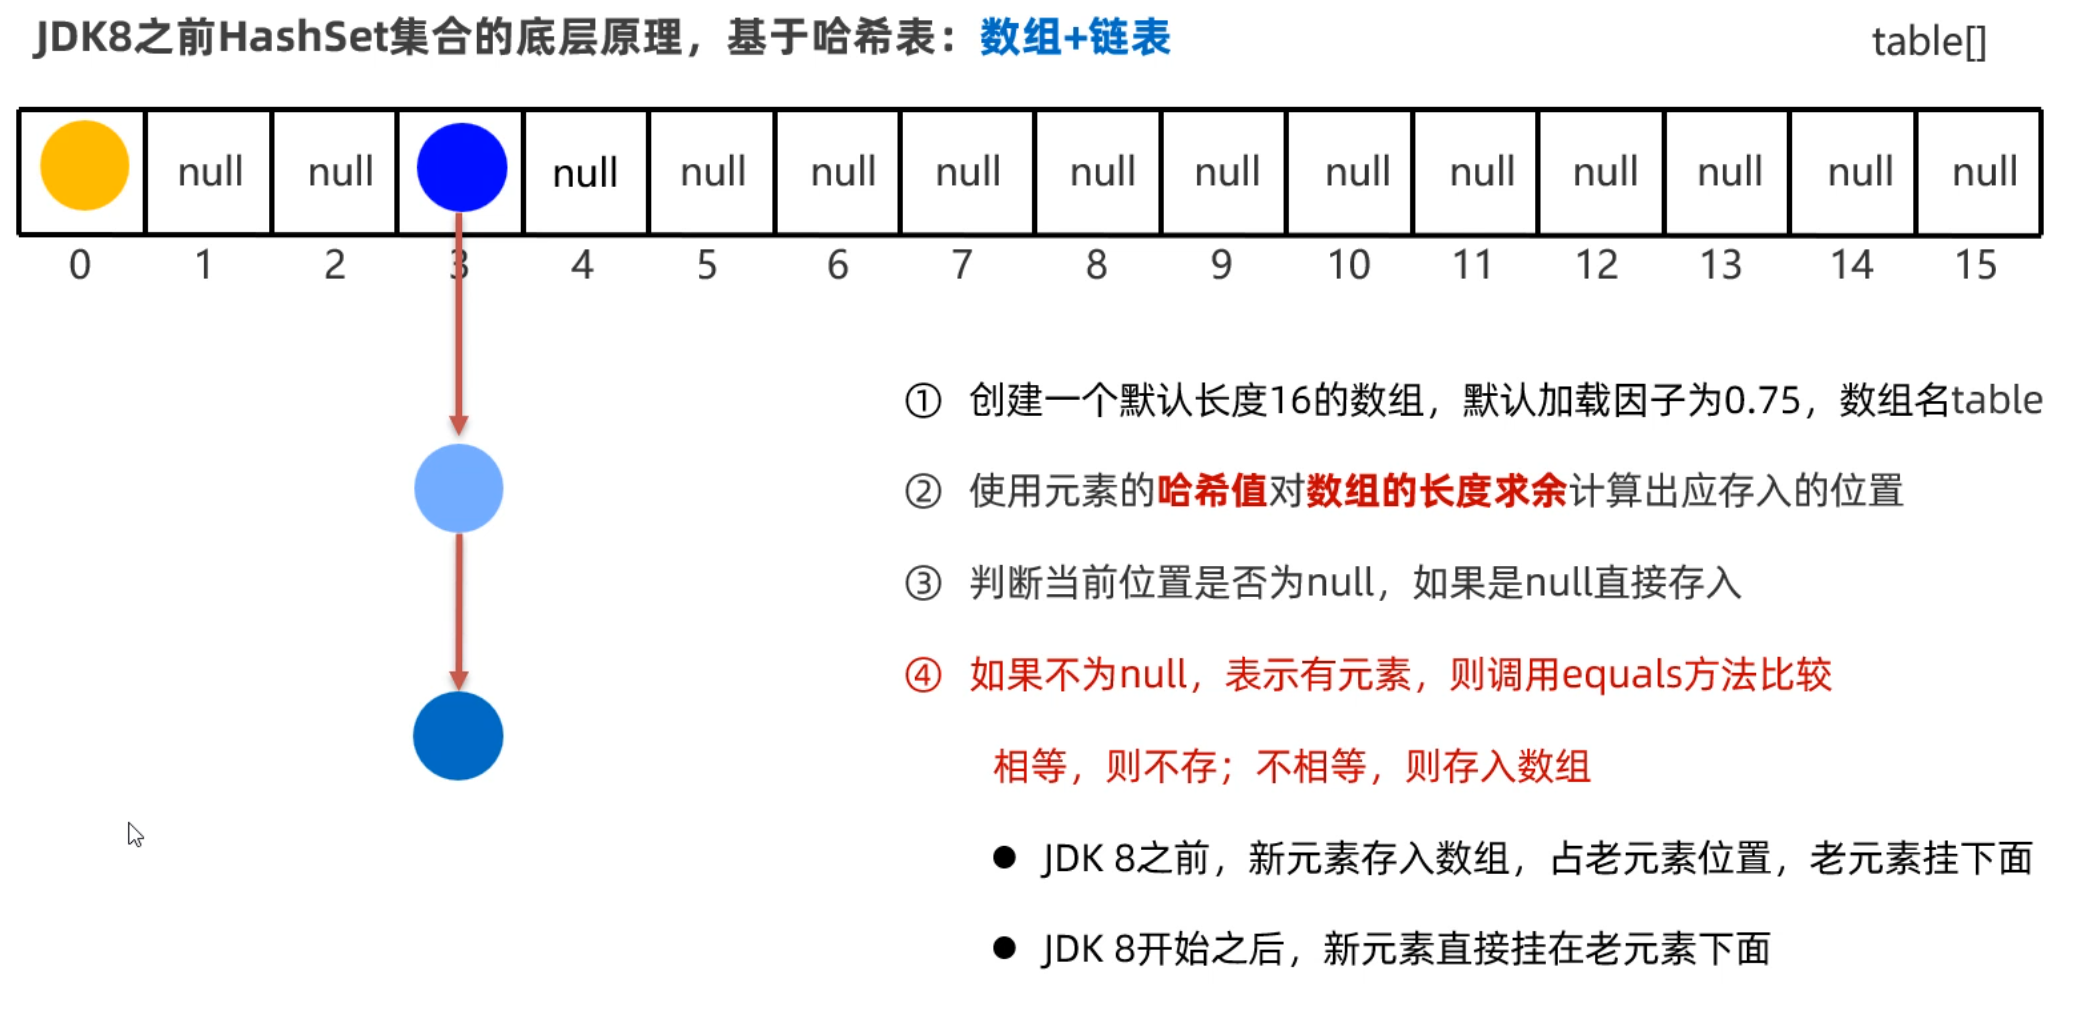
往HashSet集合中存储元素时,底层调用了元素的两个方法:一个是hashCode方法获取元素的hashCode值(哈希值);另一个是调用了元素的equals方法,用来比较新添加的元素和集合中已有的元素是否相同。
- 只有新添加元素的hashCode值和集合中以后元素的hashCode值相同、新添加的元素调用equals方法和集合中已有元素比较结果为true, 才认为元素重复。
- 如果hashCode值相同,equals比较不同,则以链表的形式连接在数组的同一个索引为位置(如上图所示)
在JDK8开始后,为了提高性能,当链表的长度超过8时,就会把链表转换为红黑树,如下图所示:
2.2 去重原理
HashSet 存储元素依赖两个方法:一个是hashCode方法用来确定在底层数组中存储的位置,另一个是用equals方法判断新添加的元素是否和集合中已有的元素相同。
-
先调用对象
hashCode()算哈希值,定位哈希表数组位置 -
如果该位置没有元素 → 直接存入
-
如果位置已有元素:
-
哈希值不同:判定不同对象,直接存
-
哈希值相同(哈希冲突):调用
equals()比较内容equals()==true:判定重复,不存储equals()==false:哈希冲突,挂在同一个位置链表 / 红黑树上
-
新建一个学生类和测试类:
package com.itheima.d1_collection_set;

import java.util.HashSet;

public class SetTest3 {
    public static void main(String[] args) {
        Student student1 = new Student("张三", "001");
        Student student2 = new Student("张三", "001");
        Student student3 = new Student("李四", "003");

        HashSet<Student> hashSet = new HashSet<>();
        hashSet.add(student1);
        hashSet.add(student2);
        hashSet.add(student3);

        System.out.println(hashSet);
    }
}
package com.itheima.d1_collection_set;

public class Student {
    private String name;
    private String sid;

    public Student(String name, String sid) {
        this.name = name;
        this.sid = sid;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public String getSid() {
        return sid;
    }

    public void setSid(String sid) {
        this.sid = sid;
    }

    @Override
    public String toString() {
        return "Student{" +
                "name='" + name + '\'' +
                ", sid='" + sid + '\'' +
                '}';
    }
}
如果我不重写 hashCode 方法,HashSet 就会调用 Object 类下的 hashCode 方法,只要hashCode 不一样,就是不同的对象,其运行结果如下所示:
[Student{name='李四', sid='003'}, Student{name='张三', sid='001'}, Student{name='张三', sid='001'}]
现在我重写 hashCode 方法,运行结果就会是这样:
[Student{name='张三', sid='001'}, Student{name='李四', sid='003'}]
就达到去重的效果了!
2.3 总结
1)HashSet 无序、不重复、无索引,底层是哈希表
2)Object 类已经 JDK 内部帮我们重写好了hashCode()与equals(),所以存字符串不需要我们手动写;自己写的实体类(Student、User),要放入 HashSet 做内容去重,IDE 一键生成这两个方法即可(IDEA:Alt+Insert → equals () and hashCode ())。
3)HashSet 集合保证元素唯一性,必须同时重写hashCode() 和equals() 两个方法,缺一不可。
4)不能使用普通 for 循环遍历(没有索引),只能使用增强 for、迭代器。
5)允许存 null ,最多存一个 null(去重)。
6)判定重复条件:hashCode 返回相同 并且 equals 返回 true
7)JDK1.8 之后哈希表 = 数组+链表+红黑树
8)链表长度大于 8,链表转成红黑树;当红黑树节点小于 6 时,退化为链表。
9)HashSet 负载因子默认为 0.75 :当数组容量达到 75% 就会扩容,数组容量翻倍。
3.LinkedHashSet
3.1 概述
LinkedHashSet 底层是哈希表 + 双向链表, 其特点有:有序,不重复,无索引。和 HashSet 相比多了一个双向链表,可以记录存储的顺序。其功能与 HashSet 差别不大。
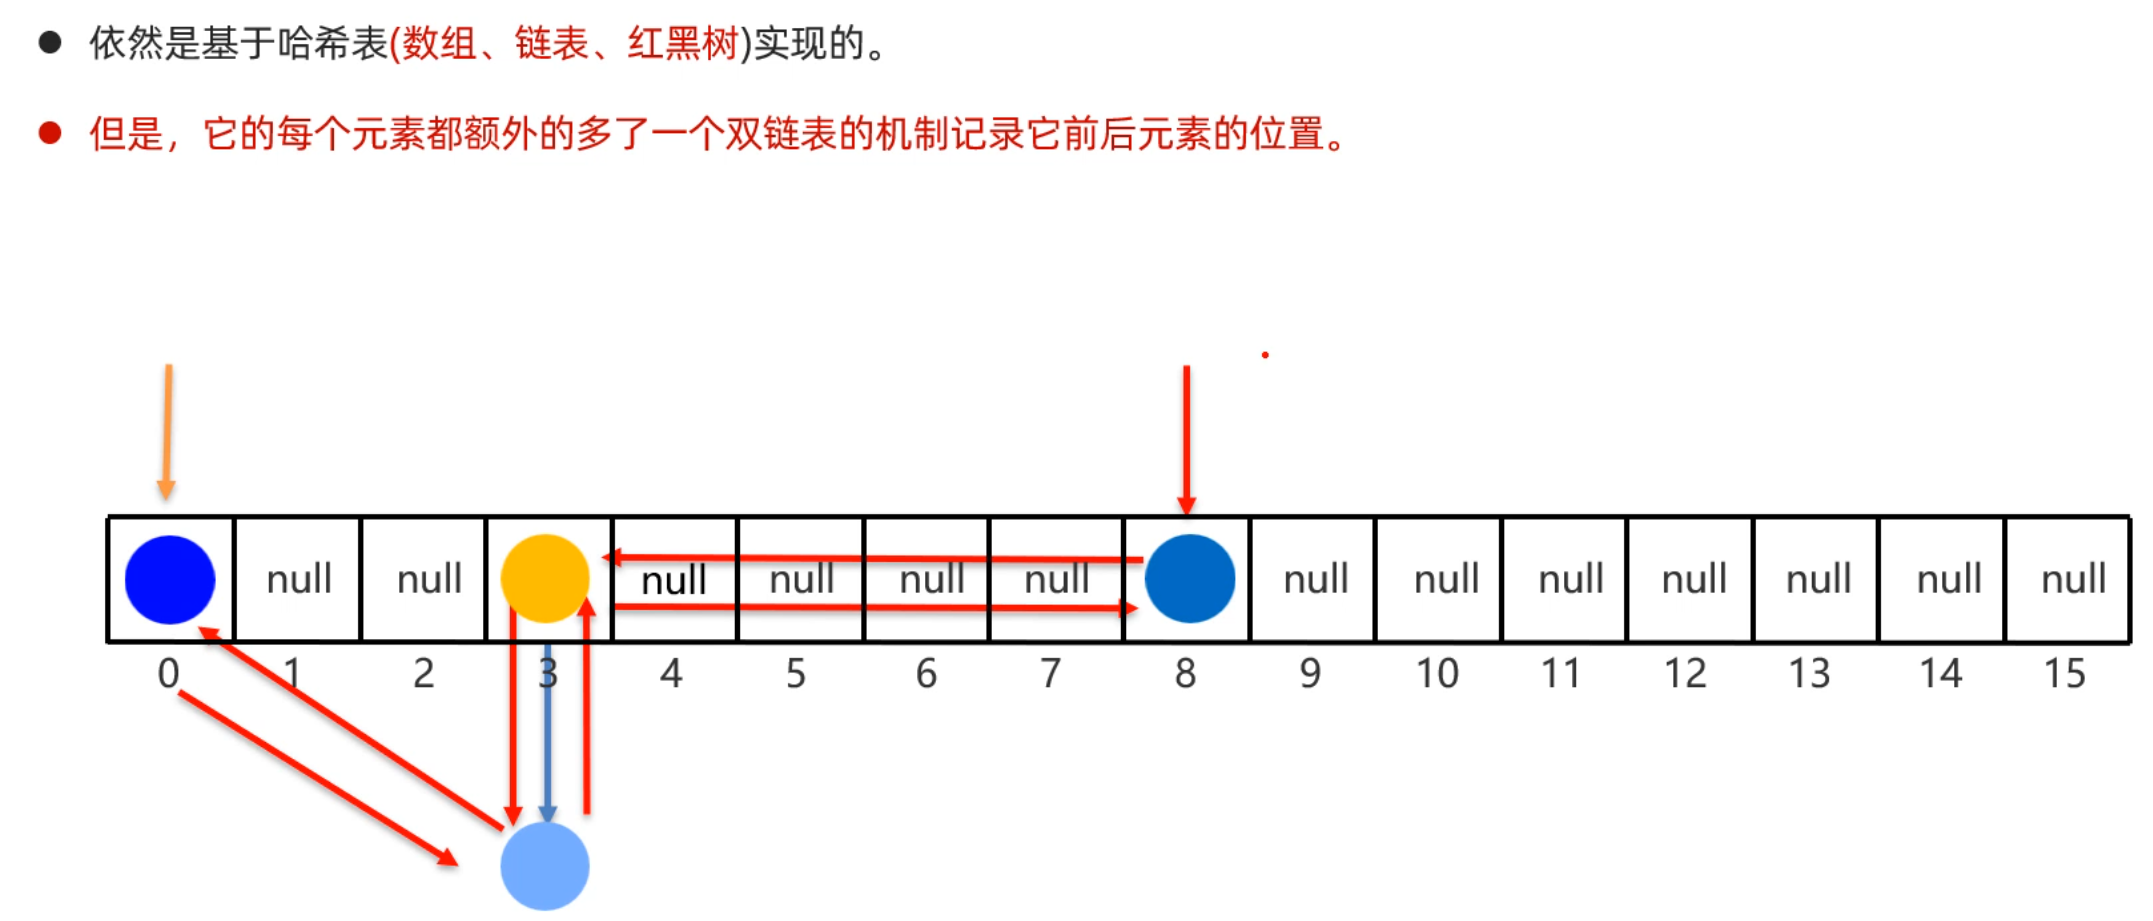
每次添加元素,就和上一个元素用双向链表连接一下。第一个添加的元素是双向链表的头节点,最后一个添加的元素是双向链表的尾节点。
4.TreeSet
4.1 概述
TreeSet集合的特点是可以对元素进行排序,但是必须指定元素的排序规则。
如果往集合中存储String类型的元素,或者Integer类型的元素,它们本身就具备排序规则,所以直接就可以排序。
例如:
Set<Integer> set1= new TreeSet<>();
set1.add(8);
set1.add(6);
set1.add(4);
set1.add(3);
set1.add(7);
set1.add(1);
set1.add(5);
set1.add(2);
System.out.println(set1); //[1,2,3,4,5,6,7,8]

Set<Integer> set2= new TreeSet<>();
set2.add("a");
set2.add("c");
set2.add("e");
set2.add("b");
set2.add("d");
set2.add("f");
set2.add("g");
System.out.println(set1); //[a,b,c,d,e,f,g]
如果往TreeSet集合中存储自定义类型的元素,比如说Student类型,则需要我们自己指定排序规则,否则会出现异常。
package com.itheima.d1_collection_set;


import java.util.Set;
import java.util.TreeSet;


public class SetTest3 {
    public static void main(String[] args) {
        Student student1 = new Student("张三", "001");
        Student student2 = new Student("李四", "001");
        Student student3 = new Student("王五", "003");

        Set<Student> treeSet = new TreeSet<>();
        treeSet.add(student1);
        treeSet.add(student2);
        treeSet.add(student3);

        System.out.println(treeSet);
    }
}
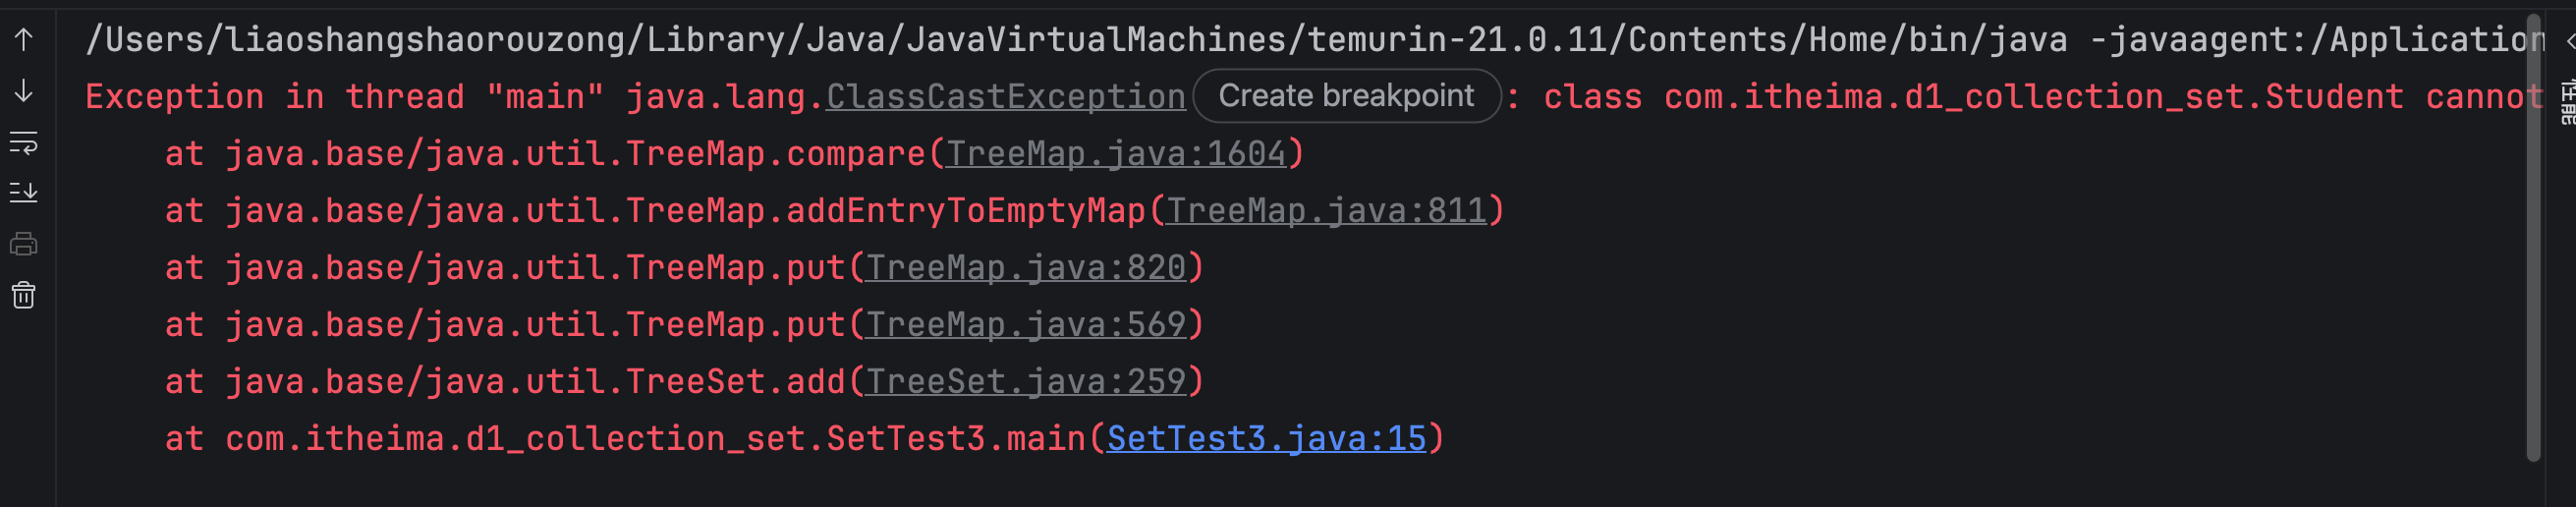
有两种方法来解决这个问题:
4.2 指定排序规则
4.2.1 自然排序
让元素的类实现Comparable接口,重写compareTo方法
package com.itheima.d1_collection_set;

import java.util.Objects;

public class Student implements Comparable<Student>{
    private String sid;
    private String name;
    private int score;

    public Student(String sid, String name, int score) {
        this.sid = sid;
        this.name = name;
        this.score = score;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public String getSid() {
        return sid;
    }

    public void setSid(String sid) {
        this.sid = sid;
    }

    public int getScore() {
        return score;
    }

    public void setScore(int score) {
        this.score = score;
    }

    @Override
    public boolean equals(Object o) {
        if (o == null || getClass() != o.getClass()) return false;
        Student student = (Student) o;
        return score == student.score && Objects.equals(sid, student.sid) && Objects.equals(name, student.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(sid, name, score);
    }

    @Override
    public String toString() {
        return "Student{" +
                "sid='" + sid + '\'' +
                ", name='" + name + '\'' +
                ", score=" + score +
                '}';
    }

    @Override
    public int compareTo(Student o) {
        return this.score - o.score;
    }
}
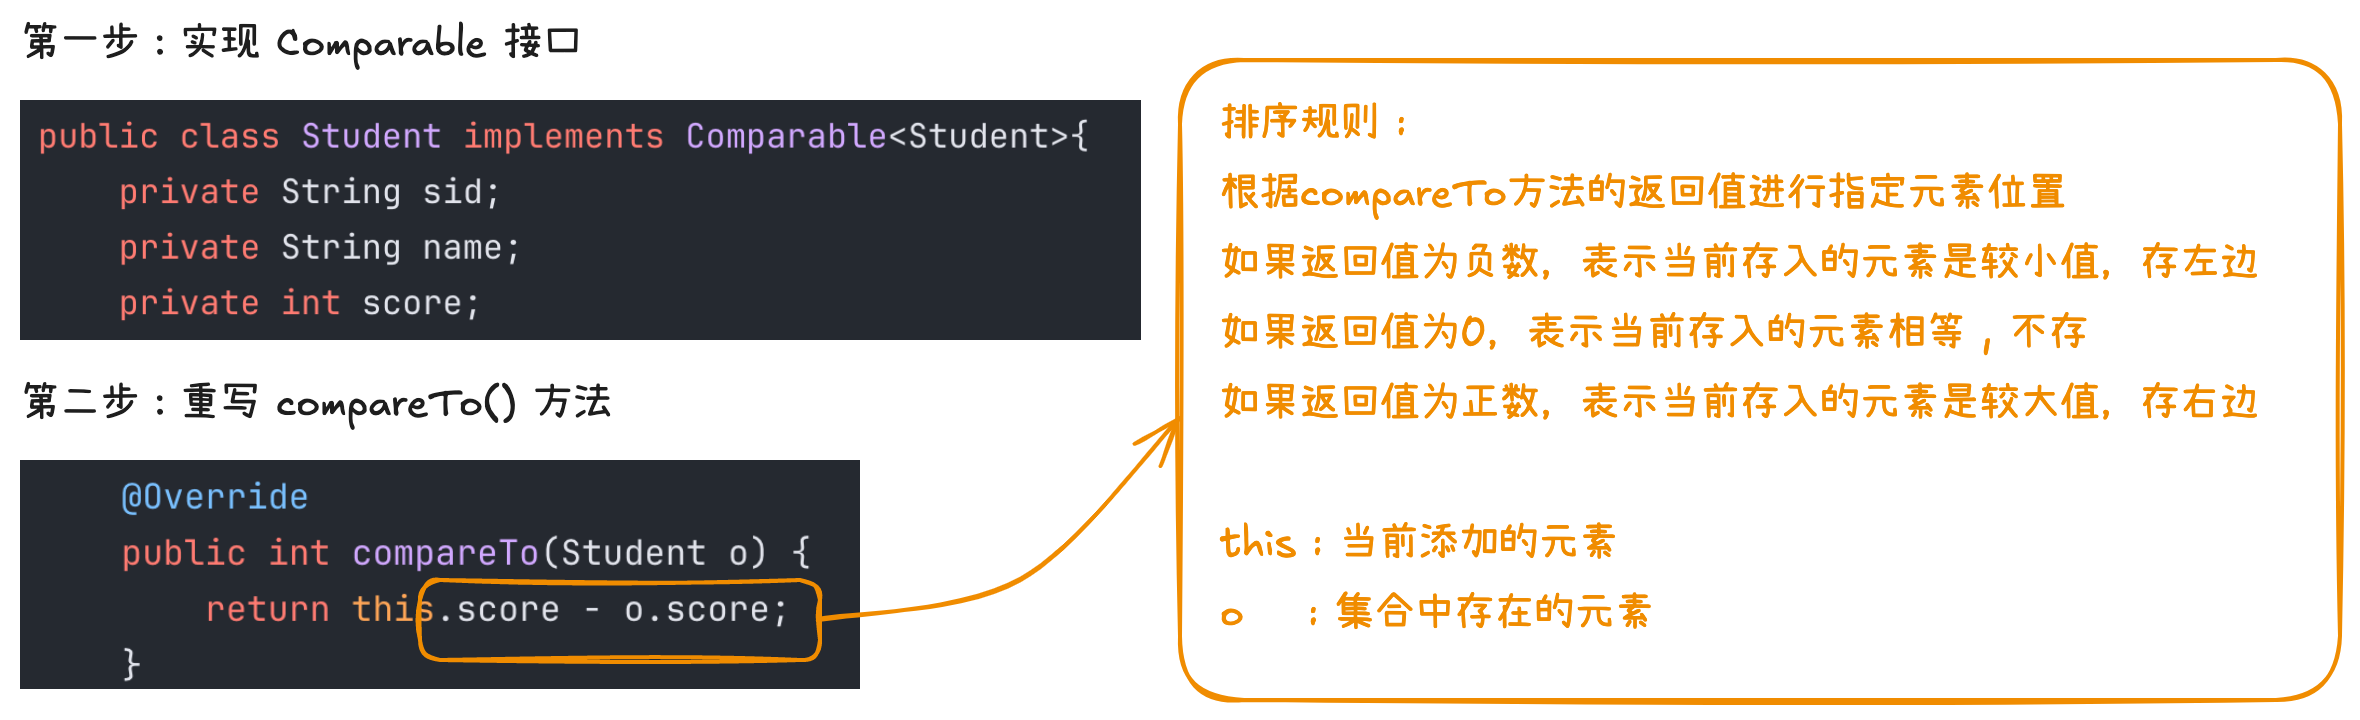
反思:
@Override
public int compareTo(Student o) {
    return this.score - o.score;
}
这样子写是不是太笼统了呢?如果两个学生的成绩是一样的话,那他不就只保留最前面那个对象了吗?事实果真如此
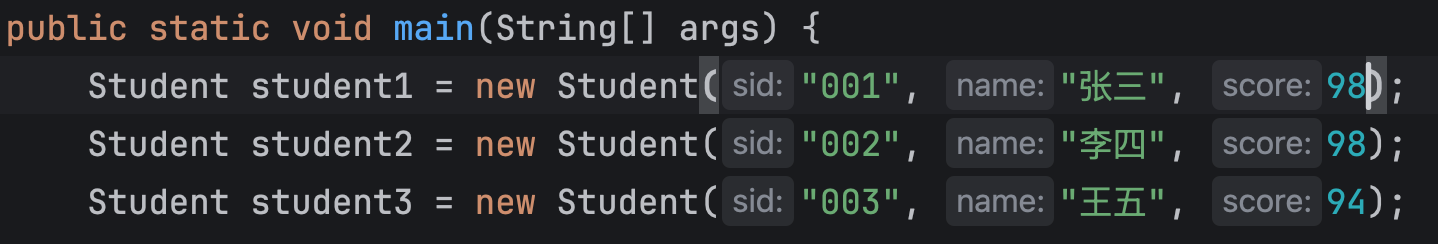
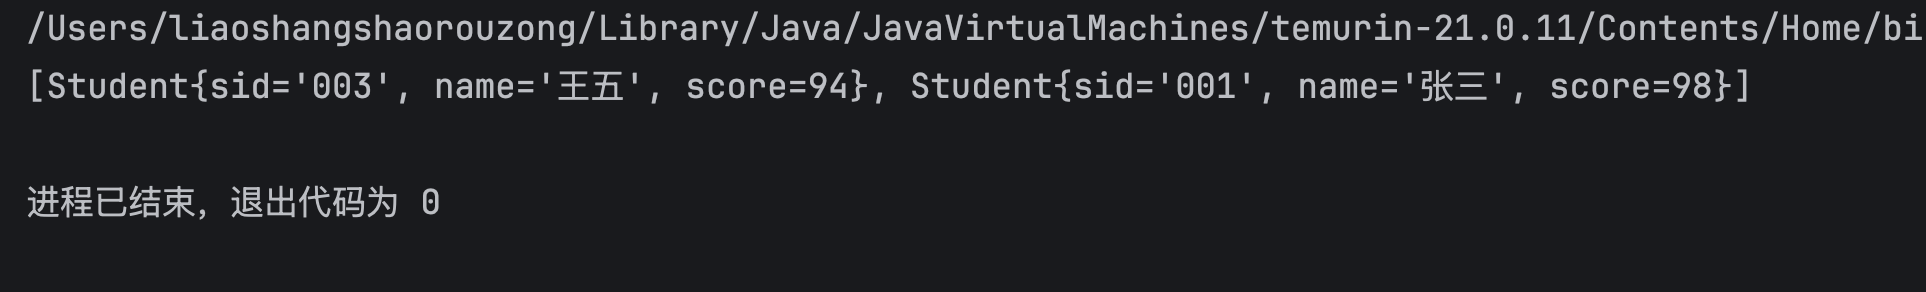
可以看到运行结果并没有李四这一项。我们要进行一些改动:
@Override
public int compareTo(Student o) {
    return this.score - o.score == 0 ? this.name.compareTo(o.name) : this.score - o.score;
}
这里运用一个三元运算符来进行判断,
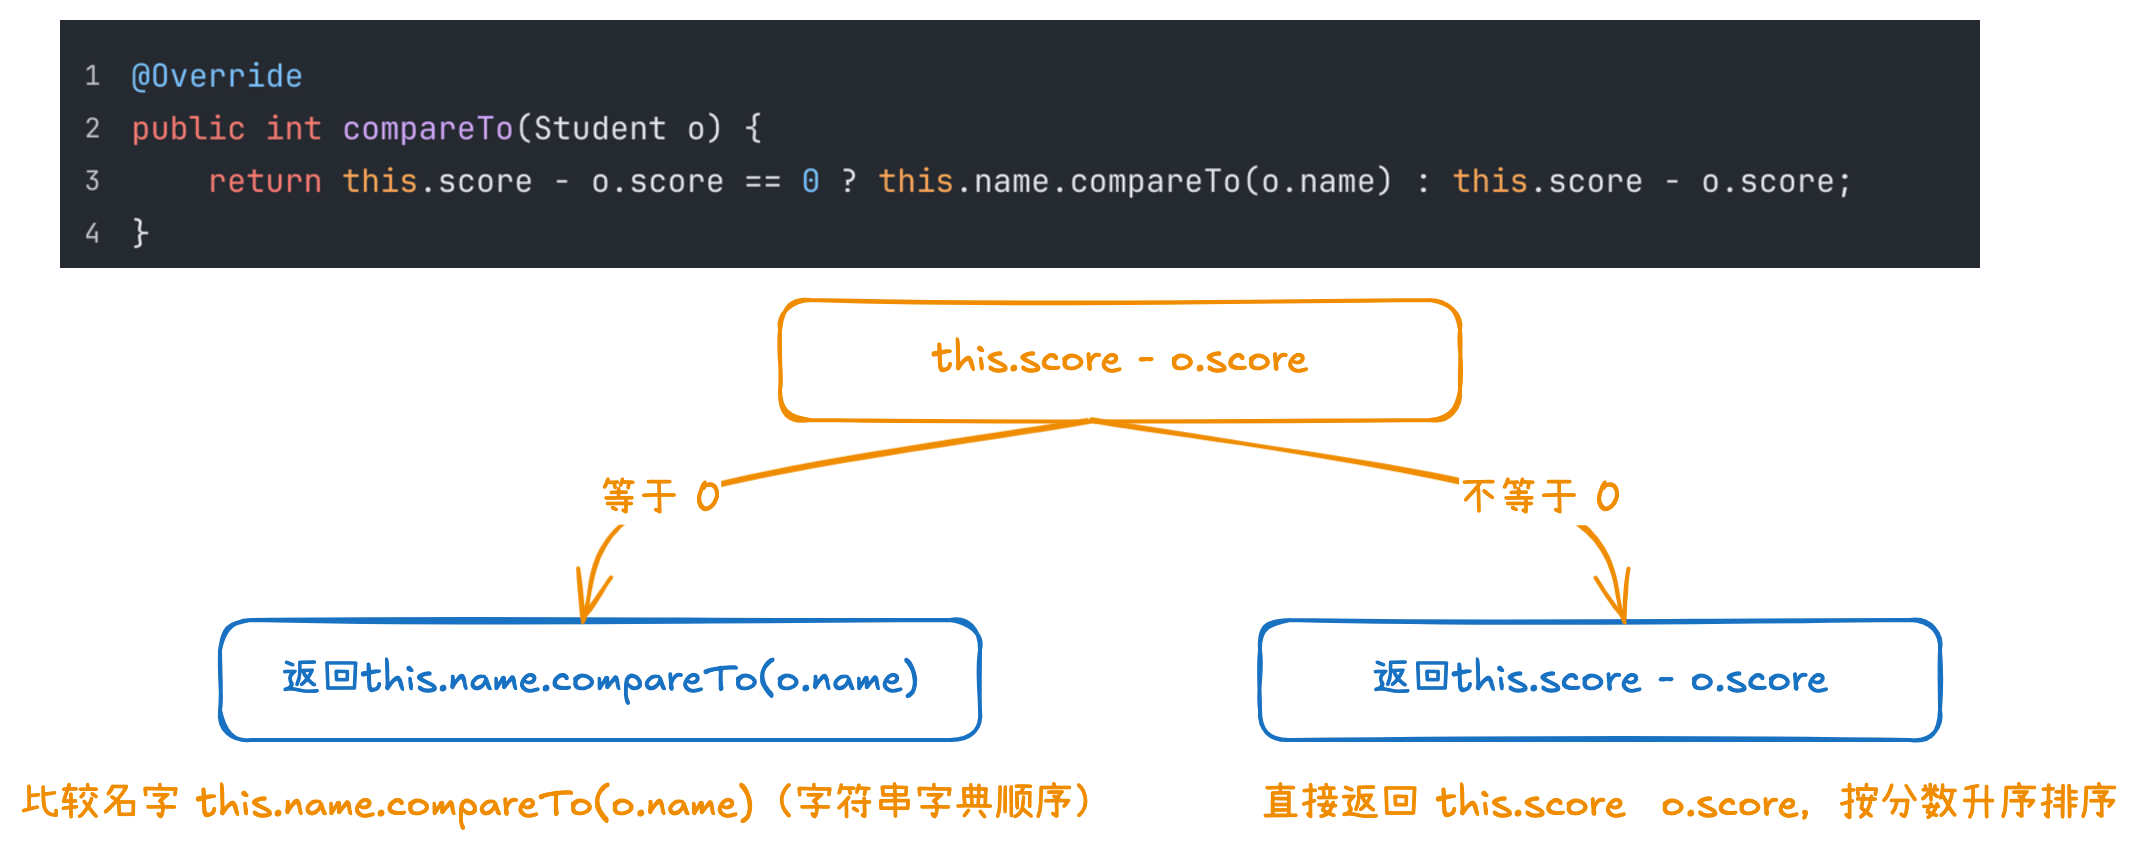
改进后
package com.itheima.d1_collection_set;

import java.util.Objects;

public class Student implements Comparable<Student>{
    private String sid;
    private String name;
    private int score;

    public Student(String sid, String name, int score) {
        this.sid = sid;
        this.name = name;
        this.score = score;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public String getSid() {
        return sid;
    }

    public void setSid(String sid) {
        this.sid = sid;
    }

    public int getScore() {
        return score;
    }

    public void setScore(int score) {
        this.score = score;
    }

    @Override
    public boolean equals(Object o) {
        if (o == null || getClass() != o.getClass()) return false;
        Student student = (Student) o;
        return score == student.score && Objects.equals(sid, student.sid) && Objects.equals(name, student.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(sid, name, score);
    }

    @Override
    public String toString() {
        return "Student{" +
                "sid='" + sid + '\'' +
                ", name='" + name + '\'' +
                ", score=" + score +
                '}';
    }

    @Override
    public int compareTo(Student o) {
        return this.score - o.score == 0 ? this.name.compareTo(o.name) : this.score - o.score;
    }
}
package com.itheima.d1_collection_set;


import java.util.Set;
import java.util.TreeSet;


public class SetTest3 {
    public static void main(String[] args) {
        Student student1 = new Student("001", "张三", 98);
        Student student2 = new Student("002", "李四", 98);
        Student student3 = new Student("003", "王五", 94);

        Set<Student> treeSet = new TreeSet<>();
        treeSet.add(student1);
        treeSet.add(student2);
        treeSet.add(student3);

        System.out.println(treeSet);
    }
}
[Student{sid='003', name='王五', score=94}, Student{sid='001', name='张三', score=98}, Student{sid='002', name='李四', score=98}]
总结:
-
实现接口:实体类实现
Comparable<泛型>,重写compareTo()方法。this代表当前对象,o代表被比较对象。 -
返回值规则
- 返回负数:
this < o,当前对象排在前面 - 返回0:判定对象重复,TreeSet 拒绝存入该元素
- 返回正数:
this > o,传入对象o排在前面
- 返回负数:
-
升降序写法
- 升序:
this.属性 - o.属性 - 降序:
o.属性 - this.属性
- 升序:
-
多条件排序(示例:先分数,后名字)
return this.score - o.score == 0 ? this.name.compareTo(o.name) : this.score - o.score;
逻辑: ①优先按分数升序; ②分数相等,执行次要条件,调用 String 的compareTo()按名字字典顺序升序; ③只有分数、名字全部相同才返回 0,才判定重复,避免同分不同名对象被错误删除。
- 核心考点
- TreeSet不依赖
hashCode() 与equals() ,完全依靠compareTo()返回值完成排序 + 去重。 - 如果只写主条件,次要属性不同但主条件相等时,会返回 0,把不同对象当成重复删掉。
- 字符串比较必须调用
字符串.compareTo(),不能直接相减。
4.2.2 比较器排序
原理:根据compareTo方法的返回值进行指定元素位置
如果返回值为负数,表示当前存入的元素是较小值,存左边 -> 升序
如果返回值为0,表示当前存入的元素相等 , 不存
如果返回值为正数,表示当前存入的元素是较大值,存右边 -> 降序
this表示当前要存储的元素 , o表示的是已经存在的元素
package com.itheima.d1_collection_set;

import com.sun.source.tree.Tree;

import java.util.Comparator;
import java.util.Set;
import java.util.TreeSet;

public class SetTest4 {
    public static void main(String[] args) {
        Student student1 = new Student("001", "张三", 98);
        Student student2 = new Student("002", "李四", 98);
        Student student3 = new Student("003", "王五", 94);

        TreeSet<Student> treeSet = new TreeSet<>(new Comparator<Student>() {
            @Override
            public int compare(Student o1, Student o2) {
                // o1:当前要存的元素;o2:已经存的元素
                return o2.getScore() - o1.getScore() == 0 ? o2.getName().compareTo(o1.getName()) : o2.getScore() - o1.getScore();
            }
        });
        treeSet.add(student1);
        treeSet.add(student2);
        treeSet.add(student3);

        for (Student s : treeSet) {
            System.out.println(s);
        }
    }
}
完
最后修改:2026 年 8 月 22 日